 KI-Einschätzung erhalten
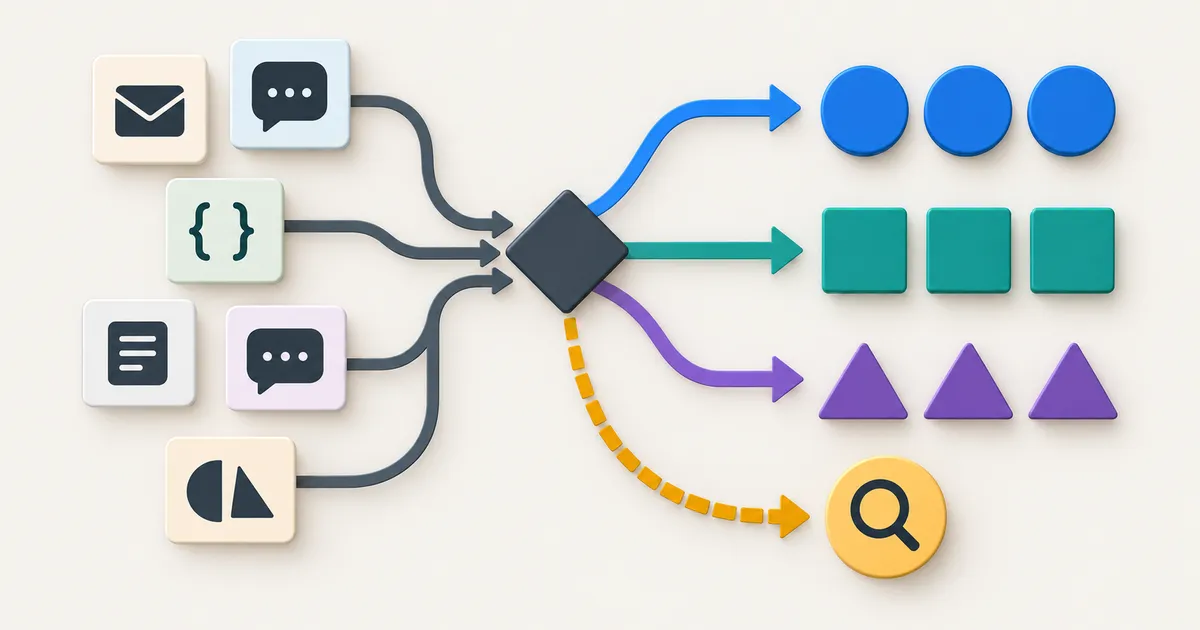
Im gemeinsamen Postfach landet eine neue Nachricht. Bevor jemand eine Antwort schreibt, stehen einige kleinere Entscheidungen an: Was möchte der Kunde? Welches Team ist zuständig? Muss sich heute noch jemand darum kümmern?
Für solche Aufgaben ist Jev von TypeSafe AI gedacht. Das am 15. September 2026 vorgestellte Modell ist das erste öffentliche System-One-Modell des Unternehmens. TypeSafe beschreibt eine neue Architektur, parallele Ausgabeberechnung und ein Training namens Reinforcement Learning for Calibrated Decisions, kurz RLCD. Das Ziel: strukturierte Entscheidungen, die Software direkt weiterverarbeiten kann. Die offizielle Ankündigung erläutert den Ansatz.
Stand: 22. September 2026. Die Leistungszahlen in diesem Artikel stammen vom Anbieter. Wir haben Jev nicht unabhängig vermessen.
TL;DR
- Jev eignet sich für eng definierte Klassifizierungs-, Zuordnungs- und Bewertungsaufgaben innerhalb von Anwendungen.
- Ein gültiges Ausgabeformat lässt weiterhin falsche Entscheidungen zu.
- Für Unternehmen zählt, welche wiederkehrenden Entscheidungen günstig und schnell genug für eine Automatisierung werden.
- Prüfen Sie den vollständigen Ablauf einschließlich unklarer Fälle, bevor Sie ihm Verantwortung übertragen.
Was bedeutet „System One“?
Der Name greift Daniel Kahnemans Unterscheidung zwischen schneller, intuitiver Einschätzung und langsamerem, bewusstem Nachdenken auf. Bei TypeSafe geben Sie relevante Informationen und klar begrenzte Fragen vor. Das Modell liefert Entscheidungen, statt Texte zu formulieren. Aktuell verarbeitet es Text und strukturierte Textdaten; Bilder, Audio und Video werden nicht direkt unterstützt. Die System-One-Dokumentation beschreibt diese Abgrenzung.
Denken Sie an einen Sortierschritt in einer Anwendung. „Möchte diese Person ihre Lieferadresse ändern?“ ist ein geeigneter Kandidat. „Löse diesen Kundenkonflikt unter Berücksichtigung unserer gesamten Geschäftsbeziehung“ benötigt einen wesentlich umfangreicheren Prozess.
Klassifizierung an sich ist längst etabliert. Interessant ist hier der Versuch, solche kleinen Einschätzungen zu einem praktisch nutzbaren Baustein zu machen, den Entwickler immer wieder aufrufen können – auch in interaktiver Software.
Was liefert das Modell zurück?
Jev bietet drei Fragetypen. Diese Beispiele zeigen, wie ein Unternehmen sie einsetzen könnte:
| Fragetyp | Beispiel | Ergebnis |
|---|---|---|
| Choice | Wohin gehört die Anfrage: Vertrieb, Service oder Sonstiges? | Eine erlaubte Auswahl, Wahrscheinlichkeiten für die Optionen und ein Konfidenzwert. |
| Score | Wie dringend ist die Nachricht nach unseren definierten Kriterien? | Eine Bewertung auf beschriebenen, geordneten Stufen mit Wahrscheinlichkeiten und Konfidenz. |
| Noul | Bittet der Kunde ausdrücklich um einen Rückruf? | Eine Wahrscheinlichkeit zwischen 0 und 1, dass die Antwort Ja lautet. |
Die offiziellen Referenzen erklären Choice, Score und Noul. Noul hat kein separates Konfidenzfeld.
Mehrere unabhängige Fragen können in einem Aufruf parallel ausgewertet werden. Die Anwendung führt die Ergebnisse anschließend zusammen. Benötigt eine Frage zuerst die Antwort auf eine andere, muss die Anwendung diese Abhängigkeit organisieren. Die Einführung von TypeSafe erläutert das Zusammenspiel.
Für einen Postfachprozess würden wir die erlaubten Teams festlegen, ihre Zuständigkeiten klar beschreiben und eine Kategorie „Sonstiges“ vorsehen. Das ist wichtig: Auch für unerwartete Anliegen muss es einen passenden Weg geben.
Typsicherheit garantiert keine richtige Antwort
Angenommen, Ihre Software akzeptiert ausschließlich sales, service oder other. Ein erlaubter Wert löst das Formatproblem. Wird eine Beschwerde als sales eingeordnet, landet die Arbeit trotzdem beim falschen Team.
Diese Unterscheidung ist entscheidend, wenn von ausgeschlossenen Halluzinationen die Rede ist. Ein begrenzter Antwortbereich verhindert erfundene Ausgabekategorien. Er beweist nicht, dass die Einordnung inhaltlich stimmt. Ein stabiles Format bedeutet auch nicht automatisch, dass wiederholte Aufrufe immer dieselbe Antwort wählen.
Unsere Empfehlung: Messen Sie getrennt, ob sich eine Antwort verarbeiten lässt und ob sie zum richtigen Geschäftsergebnis führt. Ein technisch erfolgreicher API-Aufruf kann Ihrem Team dennoch Nacharbeit verursachen.
Wahrscheinlichkeit und Konfidenz richtig nutzen
Bei Choice und Score beschreibt TypeSafes confidence, wie stark sich die zurückgegebene Wahrscheinlichkeitsverteilung auf ein Ergebnis konzentriert. Das ist etwas anderes als die Wahrscheinlichkeit einer einzelnen Option. Eine Konfidenz von 0,9 ist daher kein Versprechen, dass genau diese Antwort zu 90 Prozent richtig ist. Die Dokumentation zur Konfidenz erklärt den Unterschied.
In unserem Postfachbeispiel würden wir die Klassifizierung zunächst parallel zu den Entscheidungen der Mitarbeitenden laufen lassen. Anschließend lässt sich prüfen, welche Nachrichten sie gut einordnet und wo sie überzeugt danebenliegt. Aus diesen Beobachtungen ergeben sich sinnvolle Schwellenwerte für die automatische Zuordnung.
Für ein leicht entfernbares Themenetikett kann ein anderer Schwellenwert gelten als für die Eskalation einer dringenden Beschwerde. Schwache oder uneindeutige Ergebnisse sollten zur Prüfung verfügbar bleiben. Die Originalnachricht bleibt erhalten; die Klassifizierung ergänzt sie um eine Interpretation.
Warum Geschwindigkeit und Preis relevant sind
TypeSafe wirbt in seinen Workflow-Auswertungen mit rund 194-mal schnelleren und 445-mal günstigeren Ergebnissen. Im Ankündigungsbeitrag ordnet der Anbieter diese Werte ausdrücklich am oberen Ende der erwarteten Praxisgewinne ein. Die Vergleiche gelten für bestimmte Aufgaben. Zahlen und Einschränkungen zur Veröffentlichung.
Die Evaluationsmethodik nutzt vier Abläufe und Referenzantworten anderer großer Modelle. Die Übereinstimmung mit diesen Antworten ist ein nützlicher Hinweis, aber kein unabhängiger Beleg für korrekte Ergebnisse auf Ihren Unternehmensdaten.
Für Jev 1.13 werden 0,042 US-Dollar pro Million Eingabetokens ausgewiesen; Ausgabetokens sind kostenlos. Aktuelle Modellreferenz.
Ein Rechenbeispiel: 100.000 Aufrufe mit jeweils 1.000 abgerechneten Eingabetokens ergeben zu diesem Tarif 4,20 US-Dollar reine Modelleingabekosten. Das ist unsere Beispielrechnung, kein Projektangebot. Auch Anweisungen und Fragen zählen zur Eingabe; Integration, Wiederholungen und Nachprüfung verursachen zusätzliche Kosten.
Damit verändert sich, welche Aufgaben einen Versuch wert sind. Ein Unternehmen könnte jede eingehende Anfrage zunächst kostengünstig vorsortieren und aufwendigeres Schlussfolgern sowie menschliche Aufmerksamkeit auf die Fälle konzentrieren, die beides brauchen.
Wo wir starten würden – und wo nicht
Geeignete Pilotprojekte sind die Zuordnung eingehender Anfragen, die thematische Kennzeichnung von Kundenfeedback und das Einsortieren eines vorhandenen Textarchivs in festgelegte Kategorien. Die Ergebnisse lassen sich jeweils durch Mitarbeitende prüfen und korrigieren.
Zurückhaltender wären wir bei umfassenden Qualitätsurteilen wie „Welche dieser komplexen Implementierungen ist die beste?“. Eine eng definierte Prüfung nach einem ausdrücklichen Kriterium kann eine Bewertung unterstützen. Sie belegt keine Gesamtkorrektheit.
Das gilt auch für die Kontextverdichtung eines KI-Assistenten. Scheinbar relevante Nachrichten auszuwählen und eine zusammenhängende Zusammenfassung zu erstellen, sind unterschiedliche Aufgaben. Beim Löschen des Verlaufs können Abhängigkeiten verloren gehen, die erst später wichtig werden. Eine schnelle Filterdemo belegt nicht, dass der Assistent danach besser arbeitet.
TypeSafe dokumentiert selbst Schwächen bei Rechenaufgaben, Datumsvergleichen, indirekten Schlussfolgerungen und großen Eingaben mit vielen irrelevanten Details. Berechnungen und exakte Vergleiche gehören in normalen Programmcode. Bekannte Grenzen von Jev 1.13.
Auch die Eingabe ist begrenzt: Aktuell sind 64.000 Tokens pro Anfrage erlaubt, davon höchstens 32.000 für den Zustand plus die längste Frage. Englisch ist die dokumentierte stärkste Sprache; deutschsprachige Aufgaben benötigen eigene Tests. Modellgrenzen und Sprachunterstützung.
Was Unternehmen daraus mitnehmen können
Aus unserer Sicht werden brauchbare KI-Abläufe zunehmend mehrere Werkzeuge verbinden: normalen Code für exakte Regeln, ein Klassifizierungsmodell für begrenzte Einordnungen, ein generatives Modell für Entwürfe oder tieferes Schlussfolgern und Menschen für Ausnahmefälle.
Der erste Schritt ist eine wiederkehrende Entscheidung mit klaren Ergebnissen. Sammeln Sie typische Beispiele, verständigen Sie sich auf die richtigen Zuordnungen und messen Sie Fehler ebenso wie Zeitersparnis. Erweitern Sie den Einsatz, wenn die Ergebnisse es rechtfertigen.
Diese Prozessperspektive prägt auch unsere Arbeit mit LIVOI. Ein Modell wird dann nützlich, wenn es zu den Informationen, Zuständigkeiten und Systemen im Unternehmen passt. Dieser Artikel beschreibt eine mögliche Rolle von Jev in einer solchen Architektur; er kündigt keine bereits verfügbare LIVOI-Integration an.
Häufige Fragen
Kann Jev einen Schreib- oder Programmierassistenten ersetzen?
Es ist für begrenzte Entscheidungen konzipiert. Wenn neue Texte, Code oder eine zusammenfassende Erklärung gefragt sind, ist ein generatives Modell zuständig. Jev kann eine kleinere Entscheidung innerhalb dieses Ablaufs unterstützen.
Bedeutet typsicher auch fehlerfrei?
Die Ausgabe hält ihre Typvorgaben ein. Die ausgewählte Antwort kann trotzdem falsch sein. Außerdem benötigt die Anwendung weiterhin Fehlerbehandlung und Wege zur Nachprüfung.
Was sollten wir zuerst testen?
Eine leicht korrigierbare Aufgabe, etwa vorgeschlagene Postfachkategorien. Vergleichen Sie die Entscheidungen an echten Beispielen mit denen Ihrer Mitarbeitenden, bevor Sie automatisch weiterleiten lassen.