Letztes Jahr hat KI einen Satz ergänzt oder eine Funktion geschrieben. Heute kann ein Agent ein Problem untersuchen, mehrere Dateien bearbeiten und seine Änderungen prüfen. Die Rechnung fällt entsprechend größer aus.
Das kann sich wie ein gebrochenes Versprechen anfühlen. Sollte KI nicht immer günstiger werden?
Beides kann gleichzeitig passieren: Die Kosten für eine vergleichbare Leistungsfähigkeit sinken, während Umfang und Komplexität der eingekauften Arbeit wachsen. Wer seine Rechnung verstehen möchte, muss Tokenpreise, den Verbrauch einer Aufgabe und die Qualität des Ergebnisses auseinanderhalten.
TL;DR
- Ein günstigeres Token bedeutet nicht automatisch eine günstigere erledigte Aufgabe.
- Vergleichen Sie Modelle bei derselben Arbeit und dem Qualitätsniveau, das Sie benötigen.
- Niedrigere Kosten können viel mehr Anwendungen wirtschaftlich machen und die Gesamtausgaben erhöhen.
- Höhere Ausgaben lohnen sich nur, wenn brauchbare Ergebnisse und betrieblicher Nutzen mitwachsen.
Was war mit zehnmal günstigerer KI gemeint?
In seinem Essay Three Observations vom Februar 2025 beschrieb Sam Altman einen ungefähr zehnfachen jährlichen Rückgang der Kosten für ein bestimmtes KI-Leistungsniveau. Zugleich verwies er auf eine deutlich höhere Nutzung bei sinkenden Preisen.
Diese Einschränkung ist entscheidend. Verglichen werden die Kosten einer bestimmten Fähigkeit über die Zeit. Daraus folgt weder, dass jedes neue Spitzenmodell einen niedrigeren Tokenpreis haben muss, noch, dass jede monatliche Unternehmensrechnung kleiner wird. Ein beobachteter Trend ist auch keine Garantie für jede Aufgabe oder jedes kommende Jahr.
Denken Sie an Rechenleistung: Eine ältere Aufgabe kann günstig werden, während die anspruchsvollste neue Aufgabe weiterhin einen Aufpreis kostet. Wer den alltäglichen Assistenten von gestern mit dem leistungsfähigsten Agenten von heute vergleicht, verändert den Gegenstand des Vergleichs.
1. Tokenpreise sind nur der Ausgangspunkt
Tokens sind die Textbausteine, die ein Modell verarbeitet oder erzeugt. Anbieter können unterschiedliche Preise für neue Eingaben, bereits zwischengespeicherte Eingaben und Ausgaben berechnen. Deren Verhältnis beeinflusst die Rechnung.
Das erste Diagramm zeigt die große Preisspanne. In dieser Momentaufnahme stehen GPT-6 Astra und Claude Fable 5.1 bei 50 US-Dollar pro Million Ausgabetokens, GLM-5.3 Flash dagegen bei 0,50 US-Dollar. Dieser hundertfache Unterschied vergleicht Stückpreise. Er sagt für sich genommen nichts über gleichwertige Ergebnisse aus.
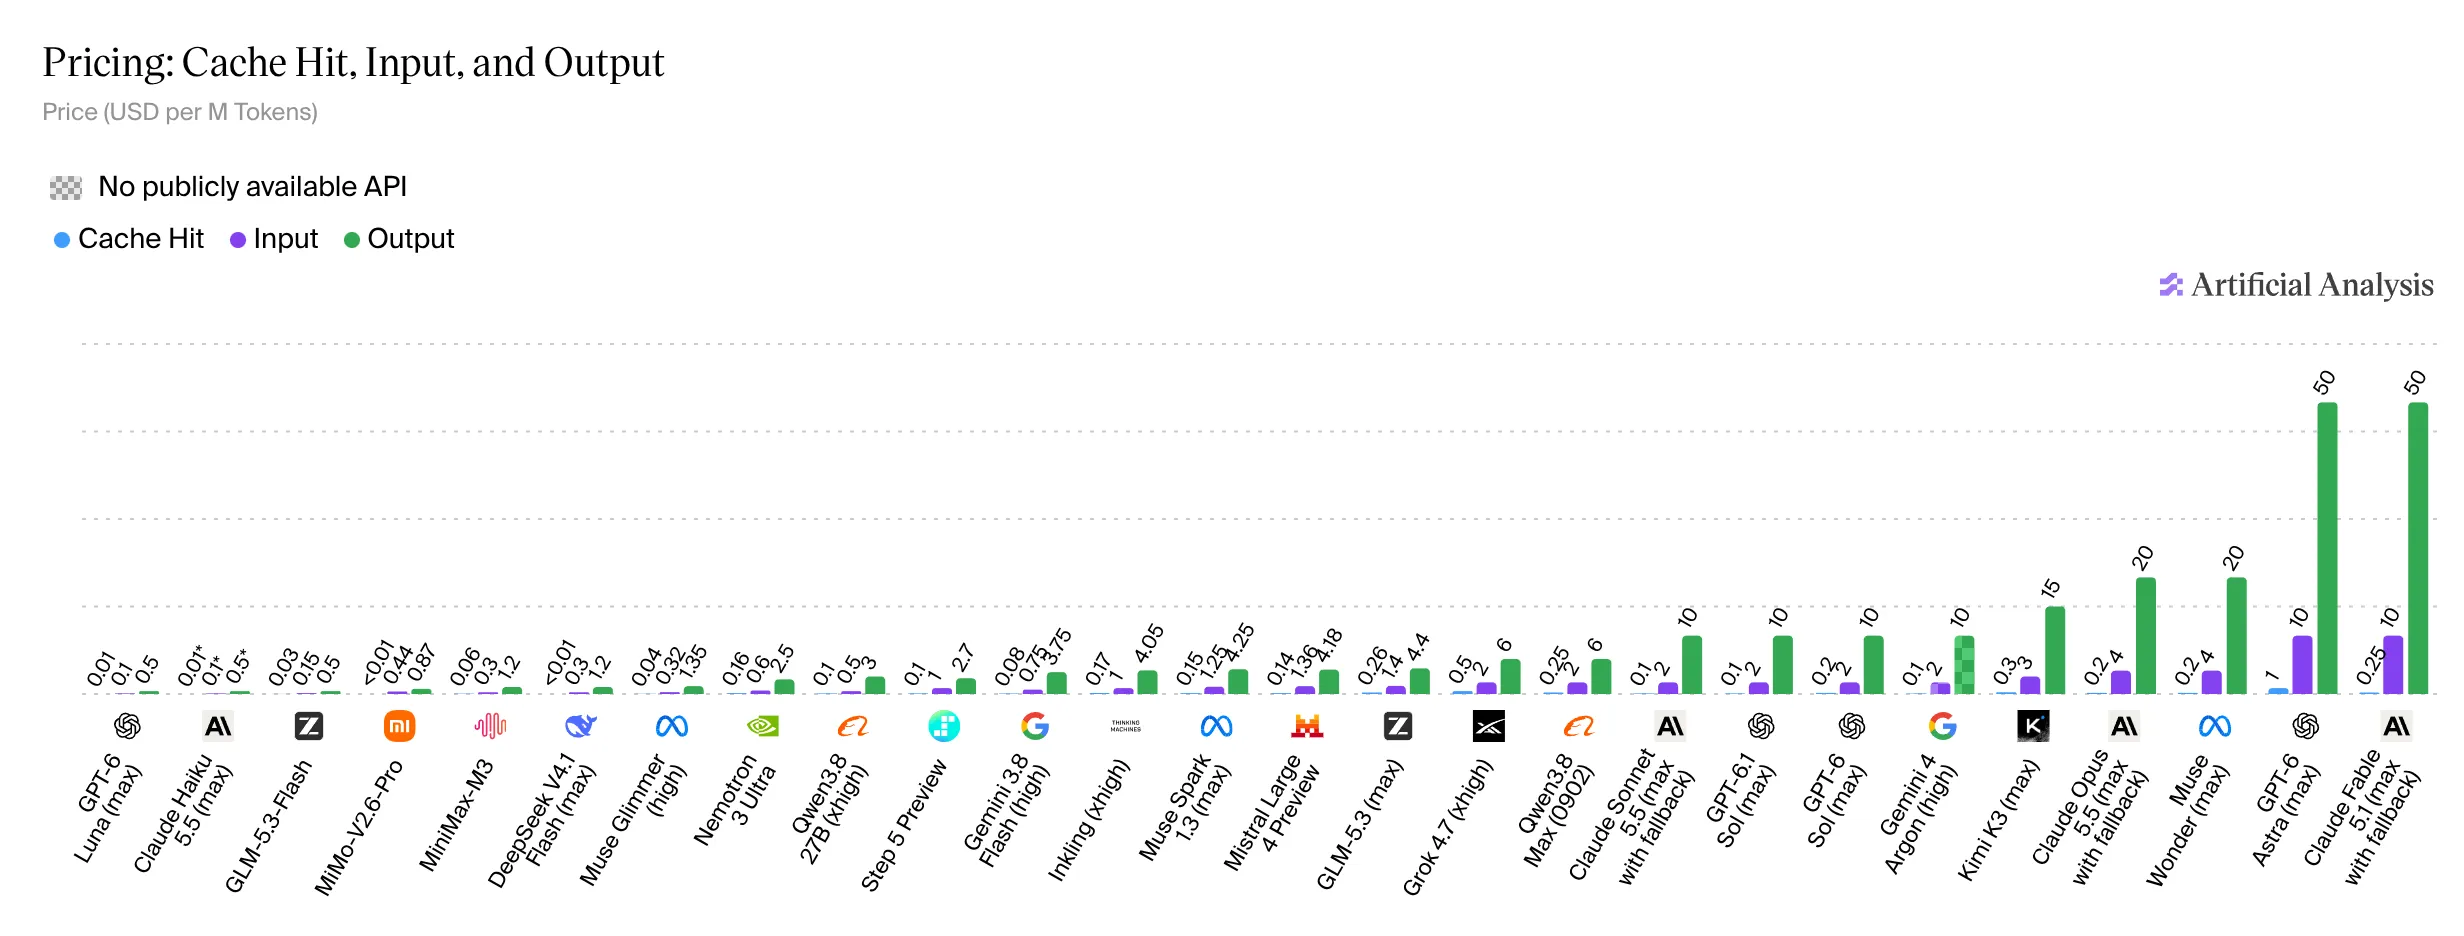
Quelle: Artificial Analysis — Preise. Originaldiagramm, exportiert am 12. Oktober 2026; Preise in US-Dollar. Öffnen Sie das Quelldiagramm, um die Beschriftungen interaktiv genauer anzusehen.
Liest ein Ablauf große Archive und erzeugt kurze Kategorien, können die Eingabekosten dominieren. Liest ein Agent wiederholt Kontext, verwendet Werkzeuge und erzeugt lange Zwischenschritte, werden Ausgaben, Zwischenspeicherung und die Anzahl der Aufrufe wichtiger. Vergleichen Sie sämtliche abgerechneten Bestandteile Ihrer tatsächlichen Aufgabe.
2. Messen Sie den Verbrauch einer Aufgabe
Ein Modell mit günstigen Ausgabetokens kann sehr viele davon erzeugen. Ein anderes verlangt mehr pro Token, benötigt aber weniger Schritte. Keines dieser Muster garantiert eine richtige Antwort.
Das zweite Diagramm trennt Antworttokens von Tokens für das Schlussfolgern. Diese Zwischenschritte zählen zum Verbrauch, auch wenn die abschließende Antwort kurz ist.
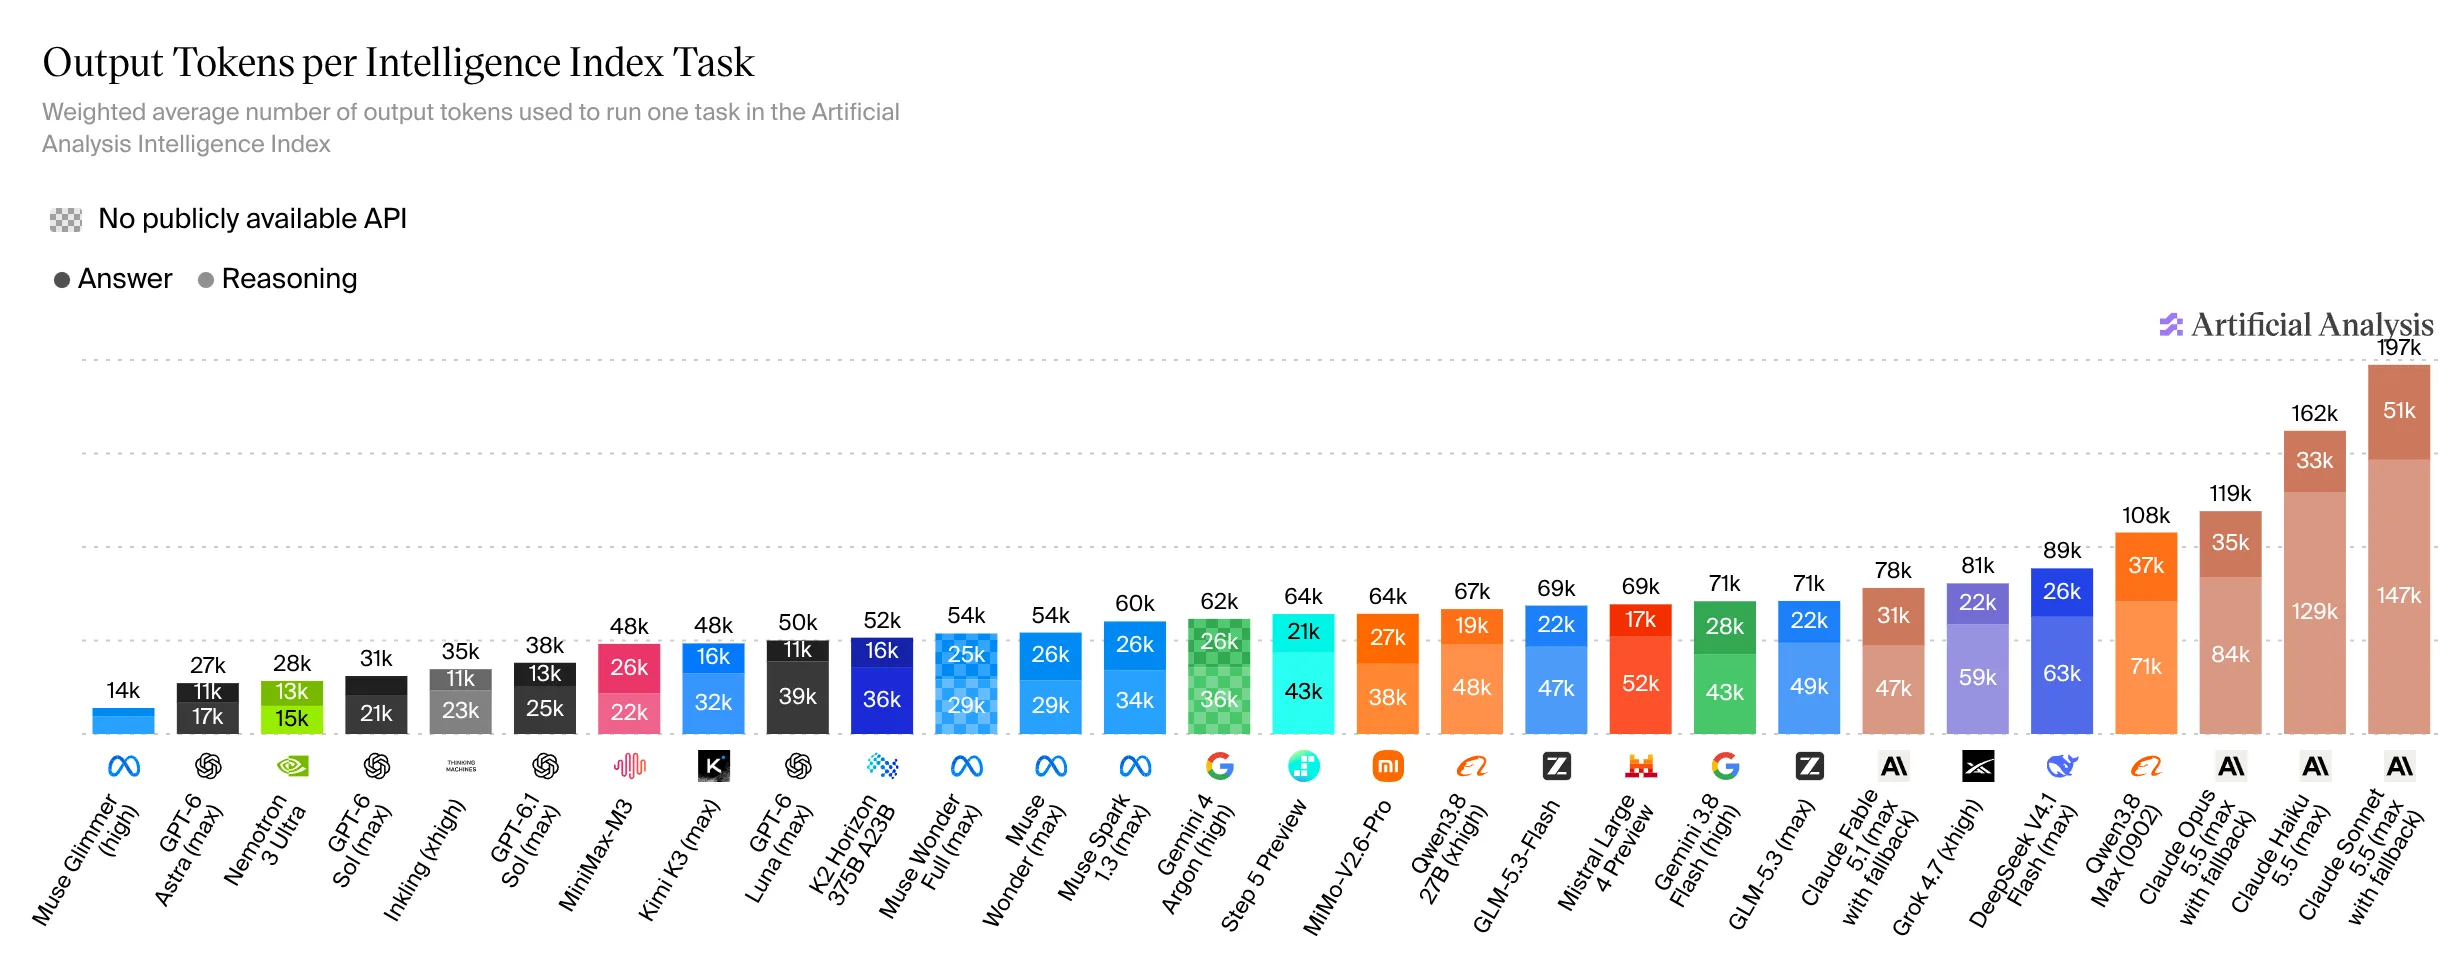
Quelle: Artificial Analysis — Ausgabetokens pro Aufgabe. Originaldiagramm, exportiert am 12. Oktober 2026. Die Balken zeigen gewichtete Mittelwerte über Benchmark-Auswertungen, keine Vorhersage für eine einzelne Anfrage.
Ein bewusst vereinfachtes Beispiel: Ein Modell kostet 1 US-Dollar pro Million Ausgabetokens und benötigt 100.000 Tokens für eine Aufgabe. Das ergibt 0,10 US-Dollar. Ein anderes kostet 5 US-Dollar, benötigt aber nur 10.000 Tokens: 0,05 US-Dollar. Der höhere Tokenpreis führt zu niedrigeren Ausgabekosten. Das sind Beispielzahlen; Eingaben, Zwischenspeicherung und Werkzeugkosten bleiben außen vor.
Im Unternehmen sollten Sie weitergehen: Teilen Sie die vollständigen Prozesskosten durch die Zahl der abgenommenen Ergebnisse. Berücksichtigen Sie Fehlversuche, Wiederholungen, Werkzeuggebühren und menschliche Prüfung. Ein günstiger Entwurf mit viel Korrekturbedarf kann teurer sein als ein besserer erster Versuch.
3. Vergleichen Sie Kosten bei der benötigten Qualität
Das nächste Diagramm zeigt die gemessene Leistungsfähigkeit auf der senkrechten Achse und die durchschnittlichen Benchmark-Aufgabenkosten auf der waagerechten. Weiter oben bedeutet einen höheren Wert; weiter links bedeutet geringere Kosten. Die waagerechte Skala ist logarithmisch: Gleiche Abstände stehen für Verhältnisse statt für gleiche Dollarbeträge.
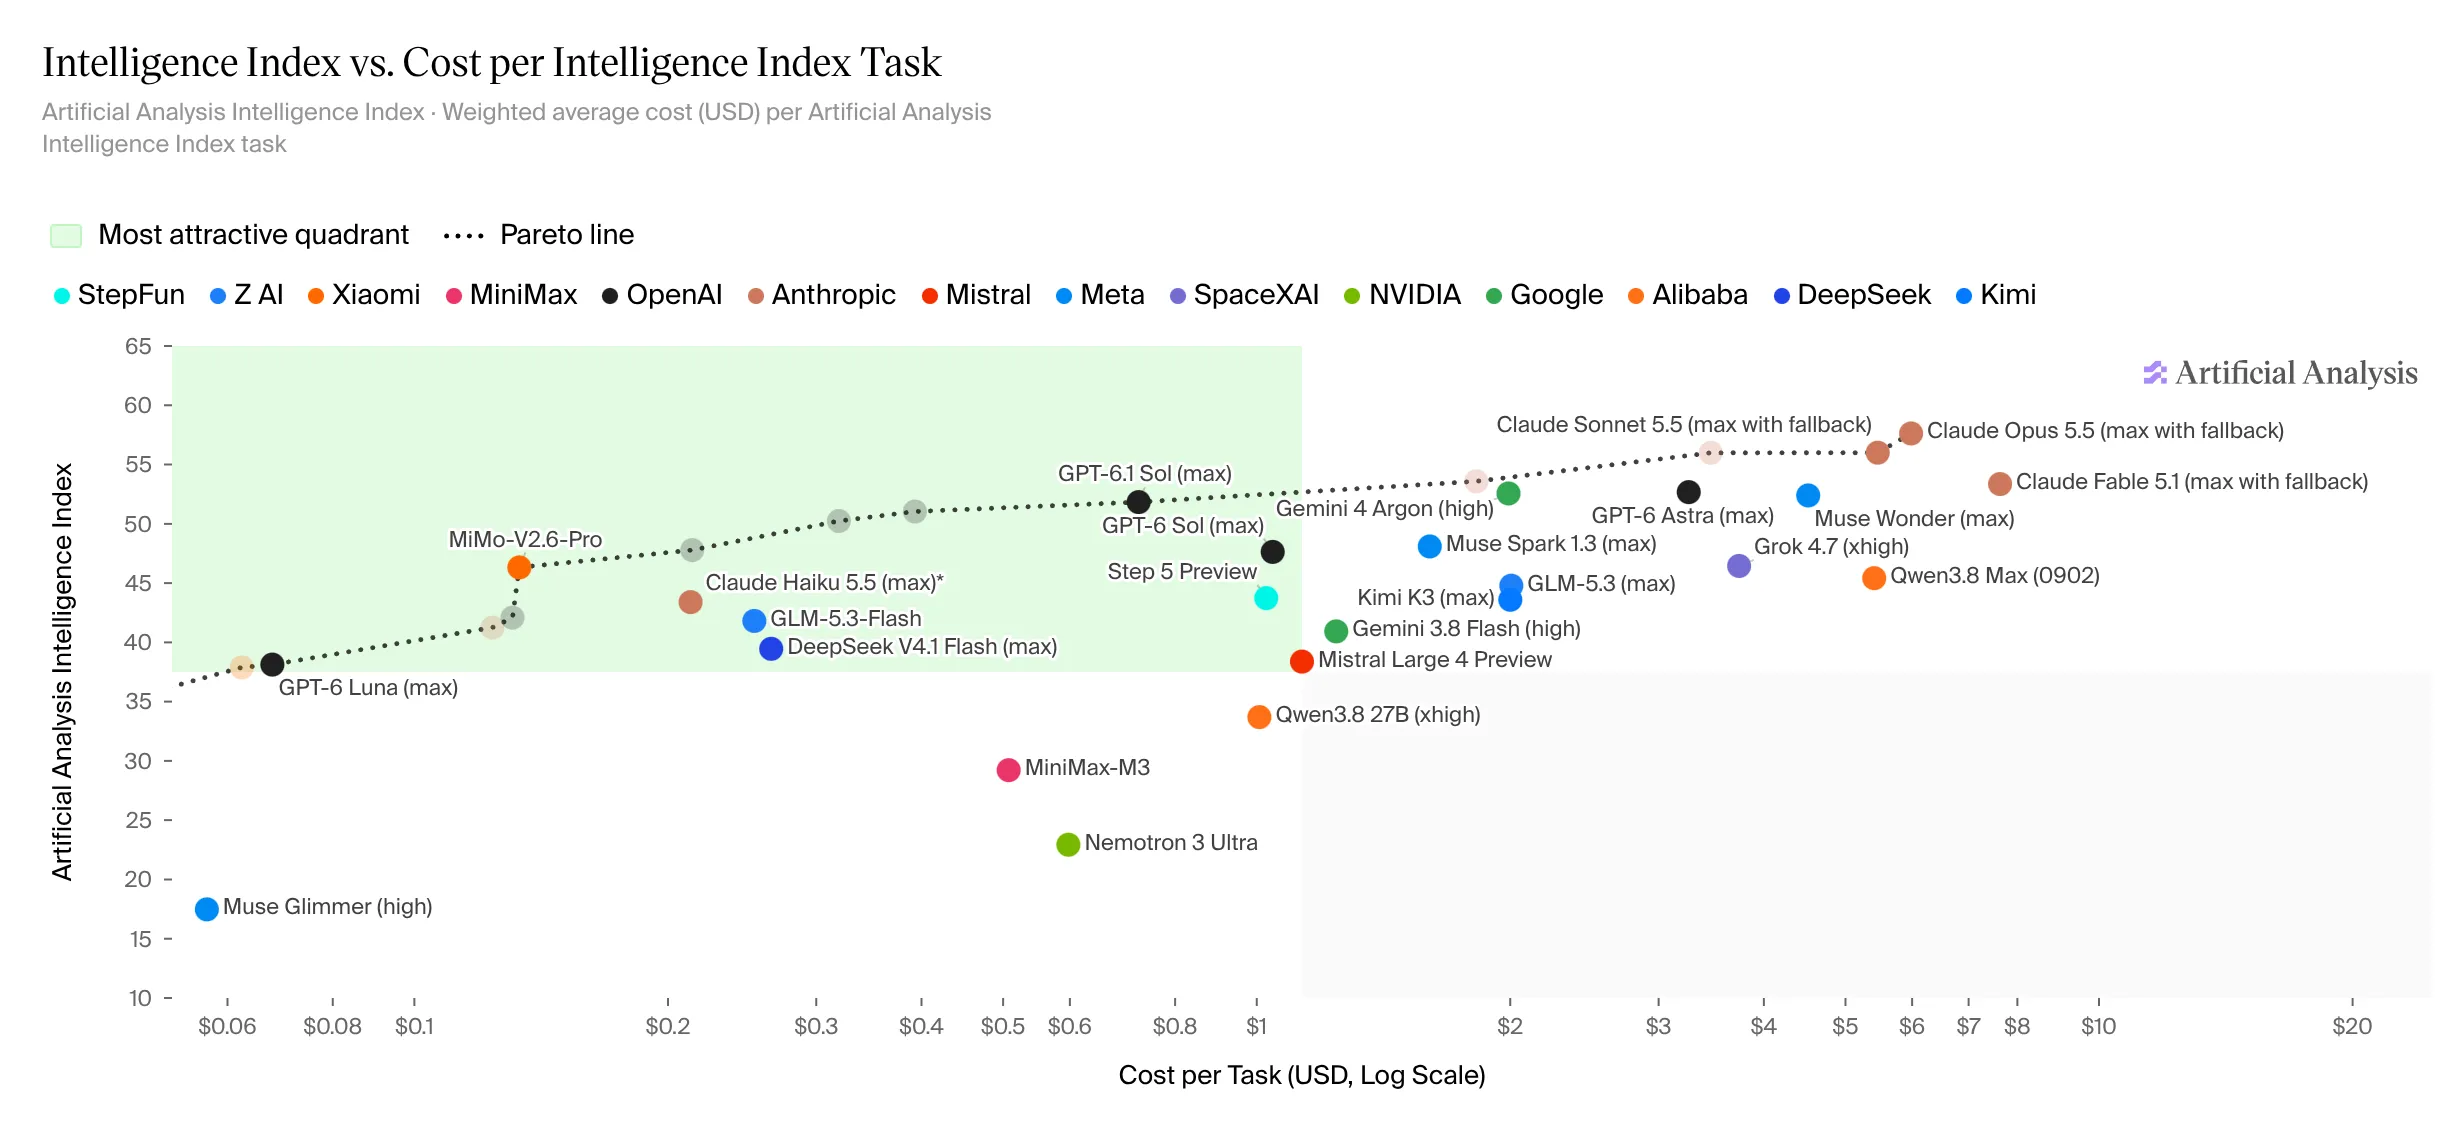
Quelle: Artificial Analysis — Leistungsfähigkeit und Aufgabenkosten. Originaldiagramm, exportiert am 12. Oktober 2026. Die gepunktete Linie markiert die Pareto-Grenze zwischen Kosten und Leistungsfähigkeit unter den dargestellten Modellkonfigurationen.
Auf dieser Grenze liegen Konfigurationen, für die keine andere dargestellte Option zugleich mindestens denselben Wert und höchstens dieselben Kosten erreicht und dabei eine dieser Größen verbessert. Das hilft bei der Vorauswahl. Ihre konkrete Aufgabe kann trotzdem ein Modell abseits dieser Linie bevorzugen.
Artificial Analysis berechnet die Aufgabenkosten aus Gebühren für Eingaben, Cache-Treffer, Cache-Schreibvorgänge, Schlussfolgern und Antworten. Anschließend werden die Auswertungen entsprechend dem Index gewichtet. Die Ankündigung zu v4.3 erklärt die Berechnung.
Ein Indexwert fasst Benchmarks zusammen. Er ist kein Prozentwert für korrekt erledigte Aufgaben in Ihrem Unternehmen. Die Methodik verweist zudem auf überwiegend textbasierte, englischsprachige Tests. Deutschsprachiger Kundenservice, bildlastige Dokumentenprozesse und spezielle technische Aufgaben brauchen eigene Prüfungen.
4. Halten Sie die Leistungsfähigkeit fest und betrachten Sie die Zeit
Dieser Vergleich kommt der ursprünglichen Kostenaussage am nächsten: Was kostet es, eine feste Leistungsschwelle zu erreichen, wenn neue Optionen erscheinen?
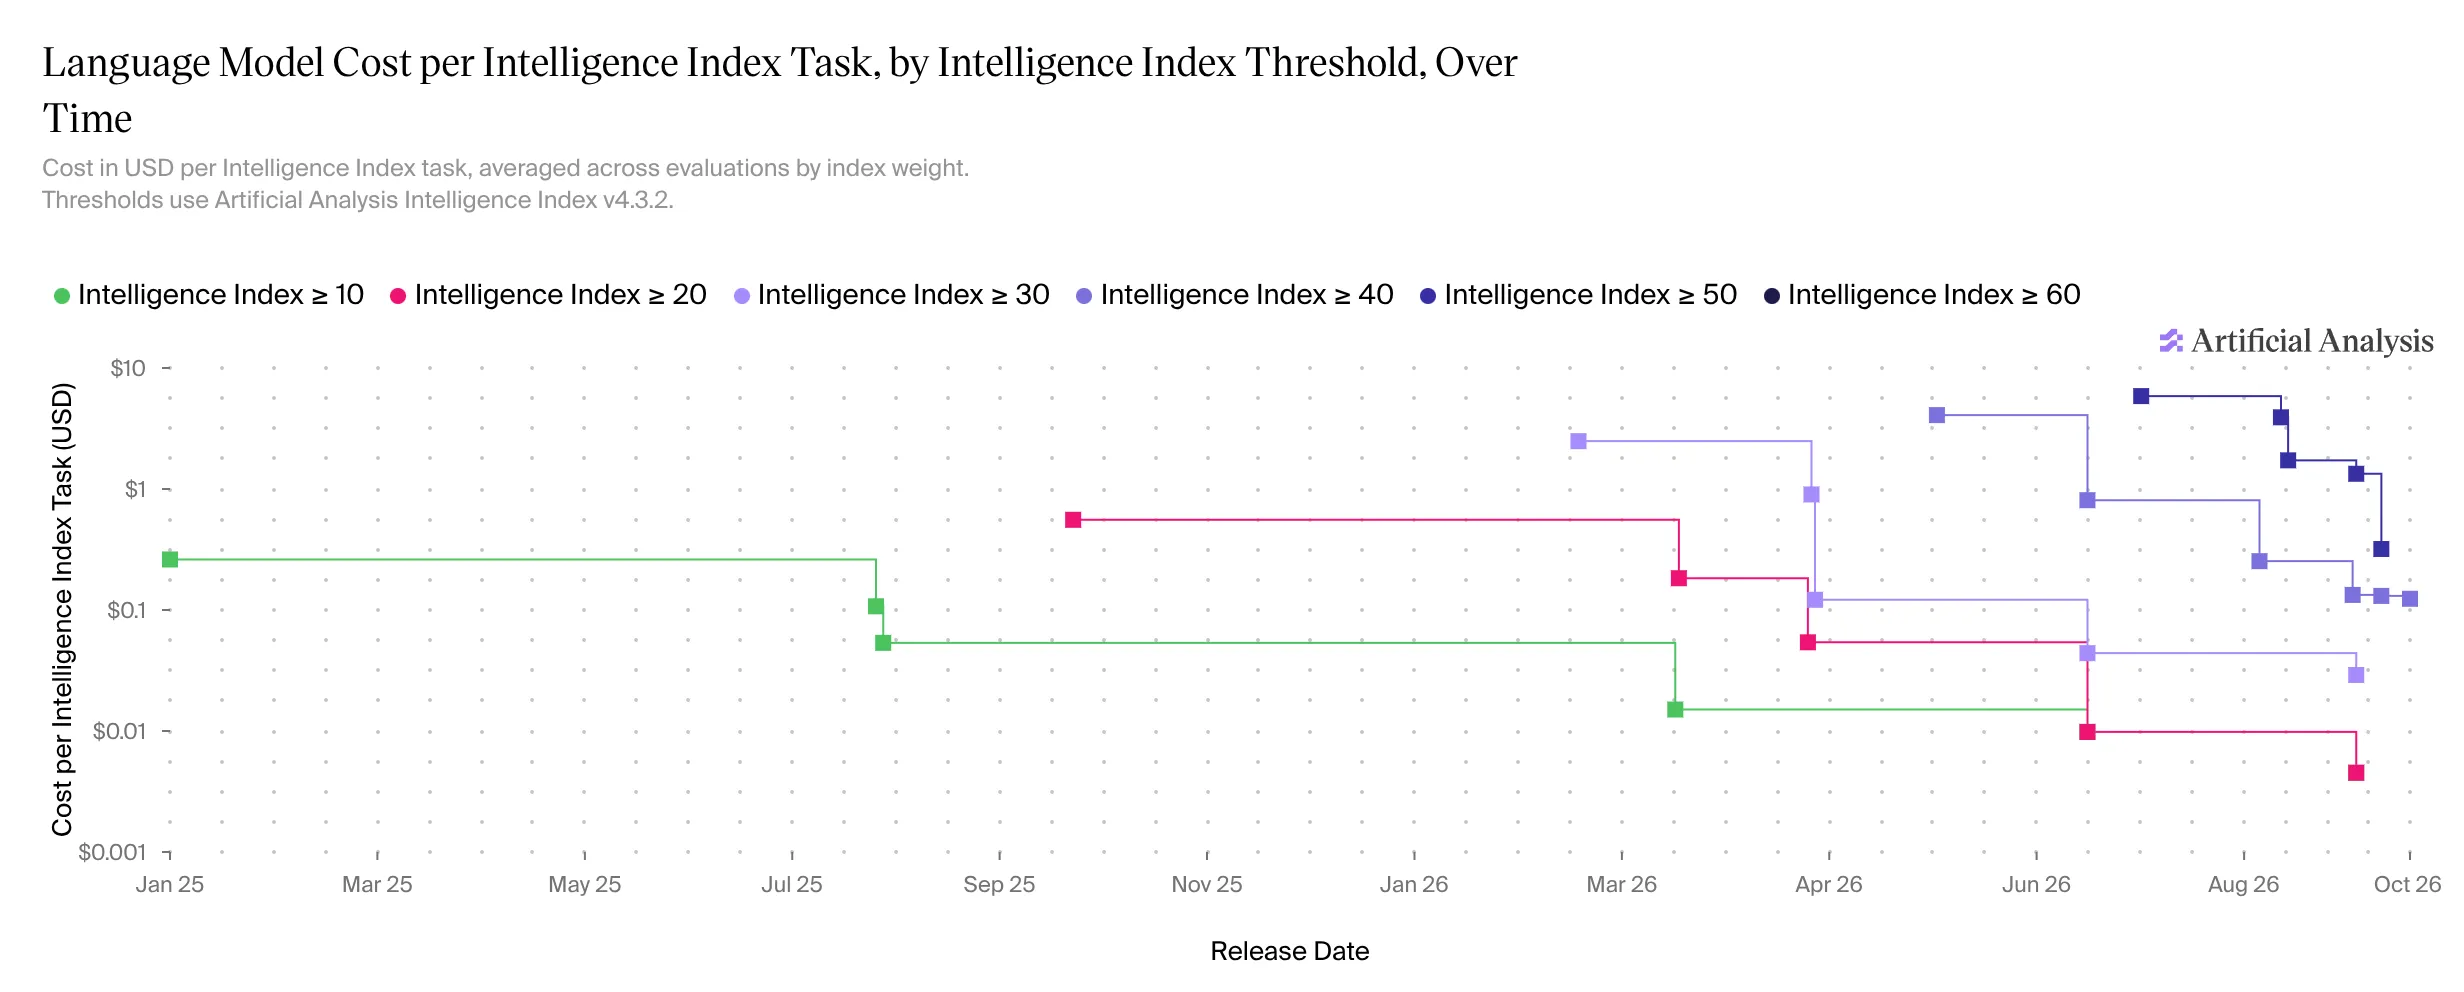
Quelle: Artificial Analysis — Kosten nach Leistungsschwelle über die Zeit. Originaldiagramm, exportiert am 12. Oktober 2026, auf Basis des Intelligence Index v4.3.2. Die senkrechte Kostenachse ist logarithmisch.
Jede Farbe steht für eine Indexschwelle. Die Schritte nach unten zeigen günstigere Möglichkeiten, diese Schwelle zu erreichen, sobald entsprechende Modelle verfügbar werden. Höhere Schwellen treten später hinzu und können anfangs teurer sein.
Das stützt die zentrale Unterscheidung: Die Kosten einer etablierten Fähigkeit können stark fallen, während eine neue Fähigkeit einen Aufpreis verlangt. Ein pauschaler zehnfacher Preisvorteil für jede Aufgabe ist damit nicht bewiesen. Außerdem ändern sich Benchmark-Versionen. Werte unterschiedlicher Versionen sind nicht ohne Weiteres direkt vergleichbar.
Die Diagramme sind datierte Momentaufnahmen der Website, keine Rekonstruktion der früheren Modellauswahl im Video. Ihre englischen Beschriftungen wurden aus den Originalexporten übernommen.
Warum die Gesamtrechnung trotzdem steigen kann
Für vergleichbare Aufgaben ist folgende Rechnung ein sinnvoller Ausgangspunkt:
Gesamte Modellausgaben = Anzahl der Aufgaben × durchschnittliche Modellkosten pro Aufgabe.
Angenommen, 200 Aufgaben kosteten früher jeweils 1 US-Dollar: insgesamt 200 US-Dollar. Später kostet dieselbe Art von Aufgabe 0,10 US-Dollar, Ihr Team erledigt aber 5.000 davon: 500 US-Dollar. Die Stückkosten sind um 90 Prozent gefallen, die Gesamtausgaben um 150 Prozent gestiegen. Das ist ein Rechenbeispiel, keine Prognose für Anbieterpreise.
Günstigere und nützlichere KI kann Arbeit wirtschaftlich machen, die sich zuvor nicht gelohnt hat. Aus einer wöchentlichen Zusammenfassung wird eine tägliche. Aus wenigen ausgewählten Anfragen werden sämtliche eingehenden Nachrichten. Aus einem Codevorschlag wird eine längere Untersuchung mit Werkzeugen und anschließender Prüfung. Das ähnelt dem Rebound-Effekt, der häufig als Jevons-Paradoxon diskutiert wird: Mehr Effizienz kann zusätzlichen Verbrauch anregen.
Das ist eine mögliche Erklärung für steigende Rechnungen, keine Diagnose für jedes Konto. Höhere Tarife, der Wechsel zu Spitzenmodellen, unnötig wiederholter Kontext und Agenten in Schleifen können ebenfalls Kosten erhöhen. Mehr Tokens belegen Verbrauch, aber noch keine Produktivität.
Was Unternehmen messen sollten
Beginnen Sie mit einem wiederkehrenden Prozess und einer klaren Definition des brauchbaren Ergebnisses. Zum Beispiel: Eine Anfrage erreicht das richtige Team, ein Antwortentwurf verweist auf die passenden internen Informationen oder eine Softwareänderung besteht Prüfung und Abnahme.
Betrachten Sie vier Kennzahlen gemeinsam:
| Kennzahl | Welche Entscheidung sie unterstützt |
|---|---|
| Kosten pro abgenommenem Ergebnis | Wird der Ablauf wirtschaftlicher? |
| Abnahme- und Korrekturquote | Gehen niedrigere Kosten zulasten der Qualität? |
| Arbeitszeit einschließlich Prüfung | Spart der Prozess tatsächlich Arbeit? |
| Menge und Gesamtausgaben | Wächst die sinnvolle Nutzung innerhalb des Budgets? |
Prüfen Sie kleinere Modelle für begrenzte Aufgaben und stärkere Modelle für anspruchsvolle Fälle. Nutzen Sie Kontext erneut, wo Zwischenspeicherung sinnvoll ist, vermeiden Sie unnötige Aufrufe und setzen Sie Agenten klare Zeit-, Schritt- und Ausgabenlimits. Für unklare Fälle sollte eine menschliche Prüfung möglich bleiben. Bewerten Sie die Modellwahl regelmäßig mit denselben repräsentativen Aufgaben.
Diese Prozessperspektive prägt auch unsere Arbeit mit LIVOI: Das brauchbare Ergebnis hängt von Informationen, Werkzeugen und Zuständigkeiten rund um das Modell ab. Unser Beitrag über Jev und strukturierte Entscheidungen betrachtet, wie ein spezialisiertes Modell einen eng begrenzten Schritt übernehmen könnte.
Häufige Fragen
Wird KI tatsächlich günstiger?
Das historische Diagramm zeigt niedrigere Benchmark-Aufgabenkosten bei festen Leistungsschwellen. Ob Ihr Prozess günstiger wird, hängt von Modell, Tokenverbrauch, Qualitätsanforderungen und Prüfaufwand ab.
Sollten wir immer das günstigste Modell nutzen?
Wählen Sie den günstigsten Ablauf, der Ihre Anforderungen zuverlässig erfüllt. Dazu können ein kleines Modell, ein stärkeres Modell, gewöhnliche Softwareregeln oder eine Kombination gehören.
Ist eine höhere KI-Rechnung ein gutes Zeichen?
Sie kann mehr nützliche Arbeit widerspiegeln. Belegen lässt sich das durch abgenommene Ergebnisse und eingesparten Aufwand. Vergleichen Sie die Rechnung mit diesen Resultaten und untersuchen Sie Ausgaben, die ohne entsprechenden Nutzen wachsen.